Зелёный CI — не доказательство: как принимать работу AI-агента

Проблема: тесты зелёные, задача не та AI-агент открыл pull request. Изменения выглядят аккуратно. Тесты зелёные. На ревью выясняется, что агент выбрал другую трактовку правила: клиент получает ответ, второй заказ при этом всё равно появляется. Код и тест согласованы друг с другом. Команда хотела проверить другое поведение. В этом месте легко обвинить модель, промпт или ревьюера. Проблема возникает раньше: агент получил задачу без заранее согласованного ответа на вопрос «какой наблюдаемый результат должен доказать тест?». ...

27 августа 2026 г. · 6 минут · Марат Киньябулатов

Как дать AI-агенту задачу и не потерять контроль

Коротко. AI-агент может открыть технически корректный pull request (PR) и всё равно решить не ту задачу: выбрать устаревшее правило, затронуть лишний сервис или обойти известное ограничение. Команде нужен короткий контракт, который до запуска фиксирует цель, границы, доказательства результата, момент остановки и владельца решения. Контракт работает вместе с техническими ограничениями: отдельными доступами, изолированной средой, обязательными проверками и review. Для изменения поведения этого недостаточно: до кода команда ещё согласует сценарий, который будущий тест обязан подтвердить. В статье — копируемый шаблон, сквозной пример и способ встроить эту практику в Git и CI. ...

24 августа 2026 г. · 12 минут · Марат Киньябулатов
The Human Loop Weekly #3 — AI-метрики взрослеют: инженер работает за ноутбуком, вокруг метрики и проверки

Human Loop Weekly #3 — AI-метрики взрослеют: от токенов к стоимости проверки

Всем привет. С вами Human Loop Weekly — еженедельный дайджест о том, как AI меняет инженерный менеджмент. Я подписан на десятки рассылок и каждую неделю сверяю их со свежими источниками, чтобы отделять рабочий сигнал от шума. В этом выпуске за окно после 17 августа и до утра 24 августа: AI-метрики взрослеют, стоимость переезжает в проверку, агенты выходят в общий поток разработки, модельные обновления становятся операционной задачей. Шкала доказательности: 🟢🟢🟢 — сильная независимая база; 🟡🟡⚪ — несколько свежих источников, крупная телеметрия, опросы или согласованные кейсы с понятными границами; 🔴⚪⚪ — ранний сигнал для наблюдения. ...

24 августа 2026 г. · 9 минут · Марат Киньябулатов
AI-native tiny teams: четыре фактора жизнеспособности маленькой команды

The Human Loop Monthly #2 — AI-native Tiny Teams: правильный вектор или хайп 2026 года?

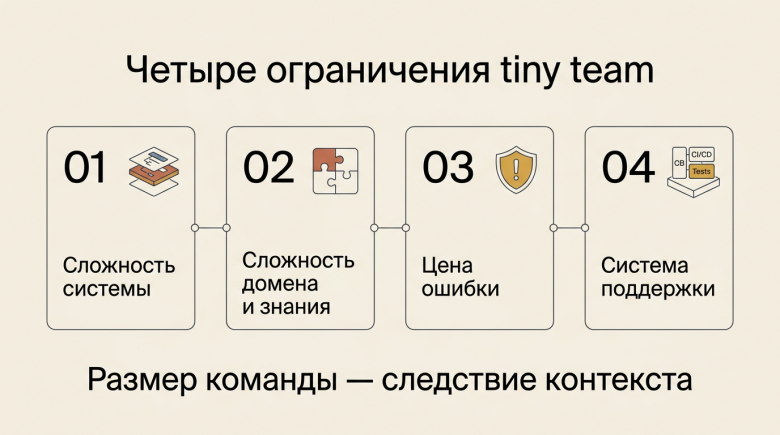
Коротко. В 2026 году один из заметных AI-native нарративов звучит примерно так: несколько сильных инженеров с агентами теперь способны делать работу, для которой раньше требовалась полноценная продуктовая команда. В этом есть правда. AI ускоряет исследование, прототипирование, написание кода, тестов и документации. Исследование Management Science, 2026 фиксирует рост производительности разработчиков, а CircleCI в отчёте State of Software Delivery 2026 показывает существенный рост throughput у наиболее эффективных команд. Но из этого легко сделать слишком сильный вывод: будто tiny team становится новой универсальной единицей разработки. На практике жизнеспособность маленькой AI-native команды зависит не столько от того, насколько хороши модели, сколько от четырёх вещей: ...

24 августа 2026 г. · 11 минут · Марат Киньябулатов
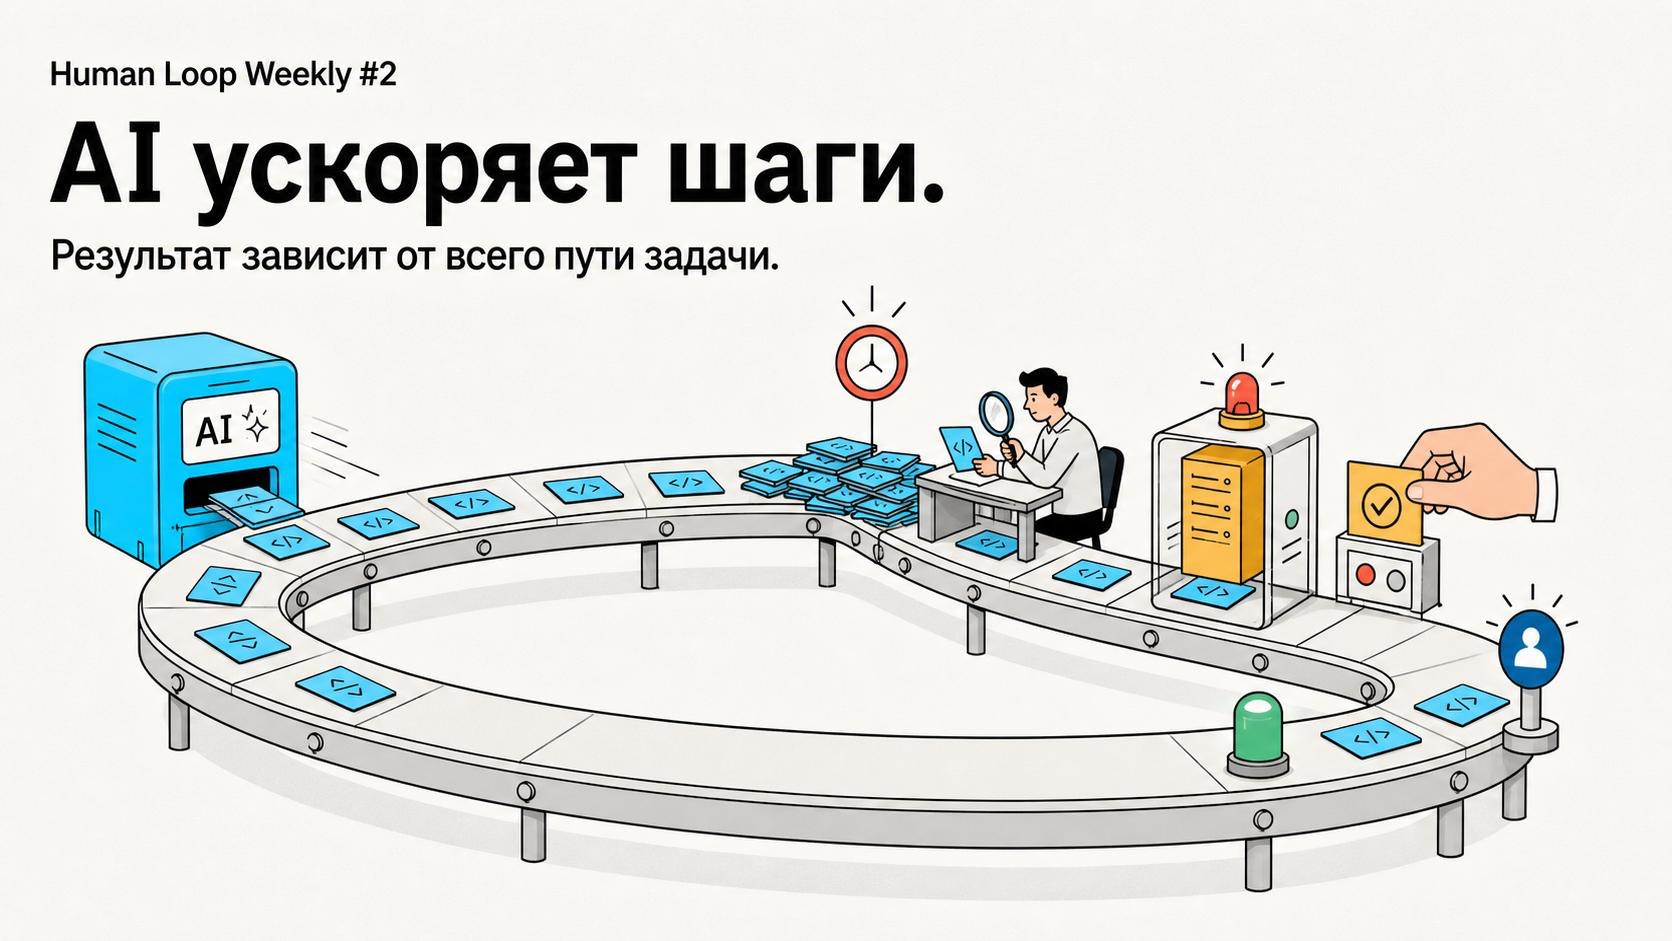
Human Loop Weekly #2: AI ускоряет шаги, а результат зависит от всего пути задачи — от подготовки кода до сигнала от пользователя.

Human Loop Weekly #2 — AI ускоряет шаги. Путь задачи всё равно проходит через очереди

Окно источников: 10 августа 2026, 08:00 — 17 августа 2026, 08:00, Asia/Yekaterinburg. Всем привет. С вами Human Loop Weekly — еженедельный разбор того, как AI меняет инженерный менеджмент. Я читаю десятки рассылок и проверяю сильные тезисы исследованиями и первоисточниками. В этом выпуске — путь задачи после локального ускорения: где возникает ожидание, как увидеть очередь и какие проверки помогают выпускать изменения без лотереи. В материалах этой недели повторяется один мотив. AI может за минуты подготовить черновик решения, кода или тестов. После этого возникает более практичный вопрос: когда изменение дойдёт до пользователя и что потребуется команде, чтобы выпустить его уверенно? ...

17 августа 2026 г. · 9 минут · Марат Киньябулатов
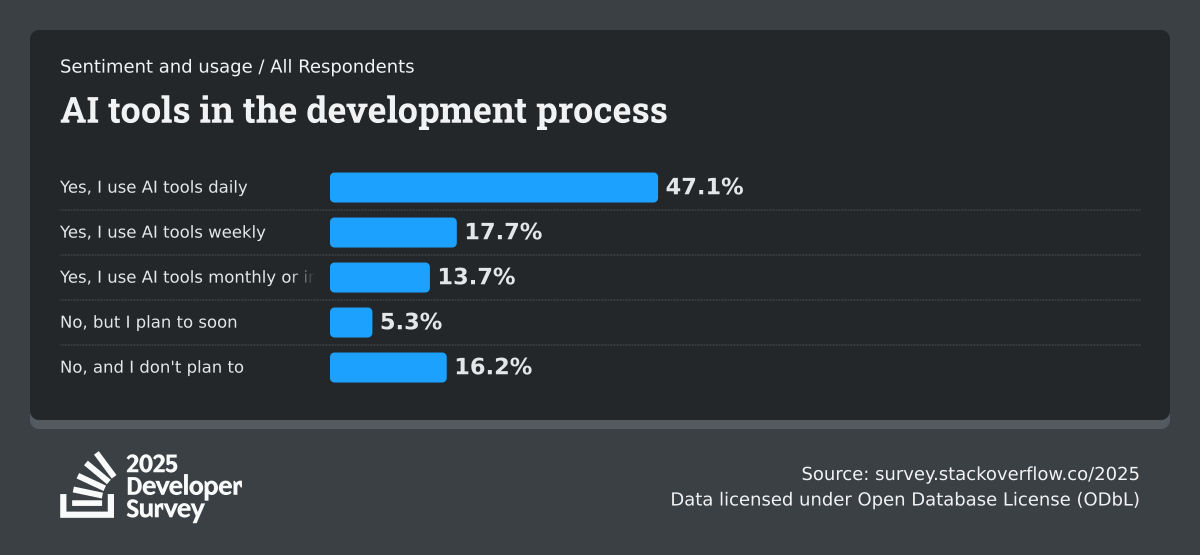
AI adoption vs trust — Stack Overflow Developer Survey 2025

Human Loop Weekly #1 — 84% разработчиков используют или планируют использовать AI, доверяют лишь 29%

Неделя 3–9 августа 2026 Всем привет. С вами Human Loop Weekly — еженедельный дайджест о том, как AI меняет менеджмент в инженерных командах: структуры, стоимость, процессы, метрики. Я подписан на десятки рассылок и исследую свежие данные каждую неделю, чтобы приносить вам самое важное про AI в инженерке и менеджменте — без воды и хайпа. В этом выпуске: почему 84% разработчиков используют или планируют использовать AI, а доверяют его точности лишь 29%; как команды из 8 человек превращаются в команды по 3–5 сеньоров с агентами; где спрятан реальный ROI (~10%, не 3×); и почему ревью кода стало дороже самого кода — и что с этим делать. ...

10 августа 2026 г. · 18 минут · Марат Киньябулатов

Запись митапа: 6 причин, почему IT-команды сопротивляются AI

Когда IT-команда сопротивляется AI, причина редко только в головах людей. Чаще это сигнал о слабом месте в системе работы: размытая цель, тревога за роль, слабый инструмент, неудобный официальный путь, неясная ответственность или очередь, которая переехала в ревью, QA, релиз и проверку бизнес-результата. На митапе я собрал эту логику в практический разбор для руководителей инженерных команд, технических руководителей, лидов доставки, лидеров изменений и руководителей AI-трансформации. ...

27 июля 2026 г. · 1 минута · Марат Киньябулатов
A giant cat sitting in a traffic jam, illustrating a bottleneck in the path to production

Agentic Engineering — это не про агентов. Это про маршрут задачи до продакшена

Мы прошли путь от первых пользователей LLM-инструментов до массового использования чатов и кодинг-агентов. На дашбордах всё выглядело правильно: люди заходили, пробовали, возвращались, приносили примеры, показывали демо, техлиды учили команды. Метрики потока при этом долго не двигались. Lead Time не снижался системно. Throughput не рос так, чтобы это было видно на уровне инженерной организации. Defect Rate не давал уверенного сигнала, что качество стало лучше. Эта статья — большая версия двух моих постов на Habr: части 1 про рост использования и метрики результата и части 2 про Agentic Engineering и AI-first команды. Здесь я собираю логику целиком: от первых LLM-чатов до следующего слоя измерения, который оказался важнее обычного дашборда внедрения. ...

15 июня 2026 г. · 12 минут · Марат Киньябулатов

Как идти к Agentic Engineering, когда структуру команды сейчас трогать нельзя

Agentic Engineering не начинается с оргчарта. Он начинается с момента, когда команда видит полный путь задачи и умеет безопасно отдавать часть работы агентам. Красивая картинка AI-native команды — 2–3 человека, E2E-ответственность, агенты в инженерном процессе, быстрый путь от идеи до продакшена. В большой организации эта картинка сразу встречает годовые цели, бюджеты, стратегические проекты, регуляторные контуры и уже собранные команды. В этой статье — три безопасных маршрута, которые можно запускать внутри текущей структуры: агентизировать нудный run-процесс, выделить 2–3 агентных практиков или собрать микро-юниты внутри команды. ...

15 июня 2026 г. · 8 минут · Марат Киньябулатов
Баг в центре очереди, вокруг него стейкхолдеры с мегафонами. Подпись: кто громче — тот прав

Кейс. Zero Bug Policy: как снизить бэклог багов в 4 раза за месяц

Баги — неизбежная часть разработки. В MetaMap мы внедрили Zero Bug Policy и за месяц сократили бэклог с 77 до 18 багов. 60 багов из 77 до старта не имели даже примерной даты исправления. Через месяц таких осталось 11. Главный результат — не красивая цифра. Support и CSM получили реальные сроки для клиентов, разработчики — ясные правила, клиенты — предсказуемость. Проблема: баги по принципу «кто громче» ...

15 мая 2026 г. · 6 минут · Марат Киньябулатов